Volgens The Information verwacht DeepSeek vanaf het vierde kwartaal van 2026 Huawei-trainingschips; dit berust op twee bronnen.
Trainen voegt een terugweg toe
Een AI-model gebruiken en een AI-model trainen zijn verschillende taken. De trainingsuitleg van PyTorch maakt het onderscheid tastbaar. Tijdens het leren doet een model eerst een voorspelling. Daarna vergelijkt de software die met de gewenste uitkomst en berekent de afwijking. Vervolgens rekent ze terug welke modelinstellingen invloed hadden op die afwijking. Een optimalisatiestap past die instellingen aan; daarna begint de volgende ronde. Bij het gebruiken van een getraind model is die bijwerkstap niet telkens nodig. Nxt-duiding: hardware die een antwoord kan uitrekenen, heeft daarmee nog niet aangetoond dat zij ook het volledige leerproces efficiënt uitvoert. Dat vraagt aanvullende berekeningen en het bewaren van informatie voor de terugweg.
Wat DeepSeek eerder daadwerkelijk bouwde
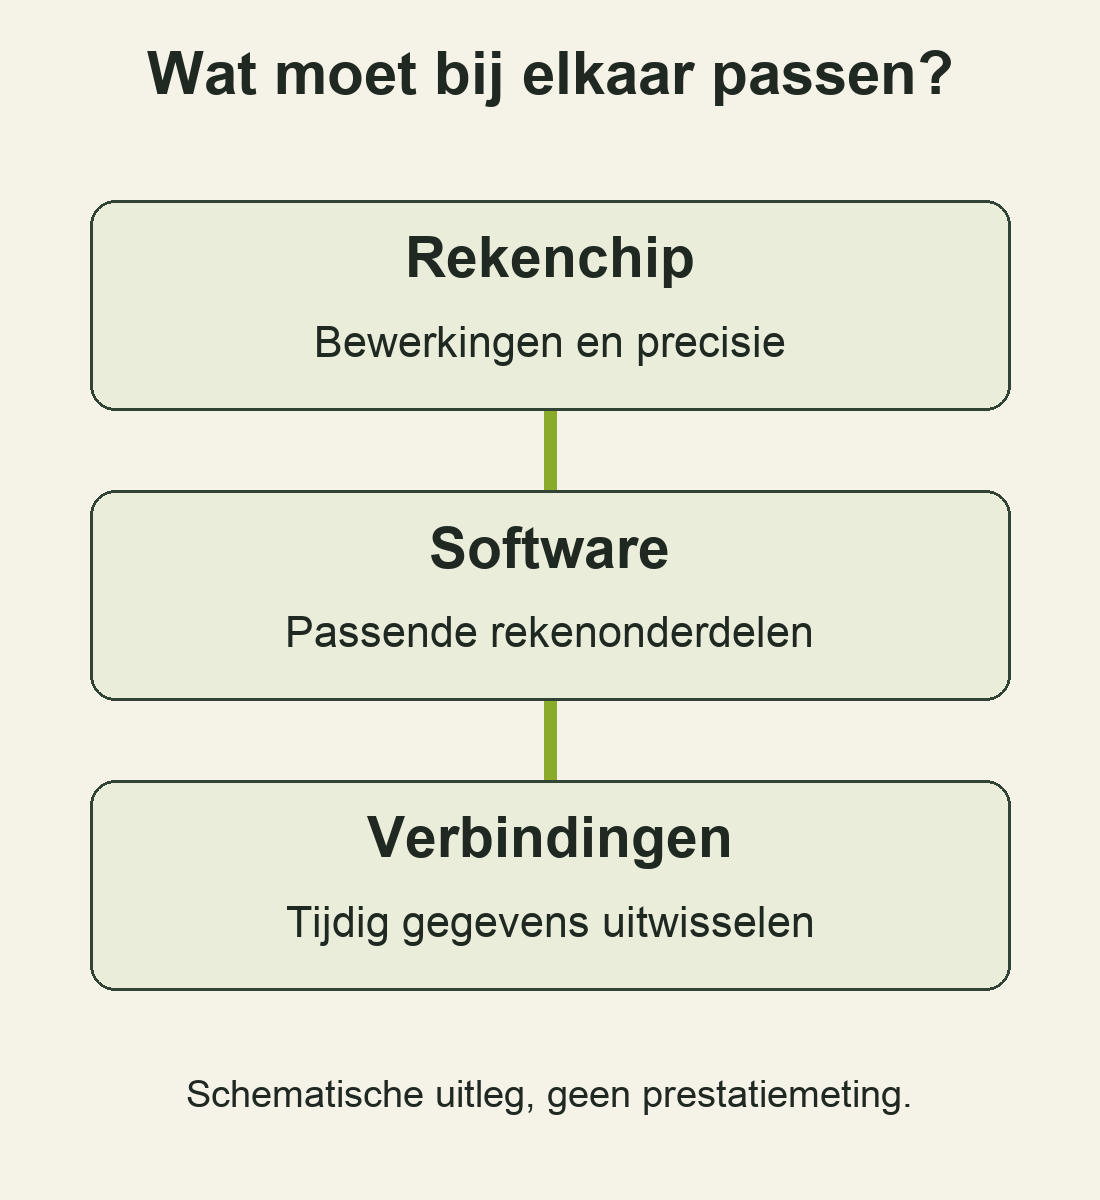
Voor een concreet praktijkvoorbeeld kunnen we terug naar DeepSeek-V3. Het technische rapport verscheen eind 2024 en werd in februari 2025 bijgewerkt. Dat model werd volgens DeepSeek getraind op 2.048 NVIDIA H800-chips. V3 heeft 671 miljard parameters, de instelbare getallen van het model, waarvan er per token 37 miljard actief zijn. Een token is een stukje tekst. Deze verdeling heet mixture of experts: per stap worden bepaalde modelonderdelen geselecteerd. Binnen iedere server waren acht chips onderling verbonden; tussen servers liep een ander netwerk. Die verbindingen vervoeren informatie tussen de rekenonderdelen, zodat het verdeelde model als geheel zijn werk kan uitvoeren. Dit is gedocumenteerde achtergrond over V3, geen beschrijving van een toekomstige Huawei-installatie. Het voorbeeld maakt wel duidelijk dat een groot model al over meerdere apparaten verdeeld kan zijn.
Ook het soort getallen telt
Een apart DeepSeek-onderzoek uit mei 2025 beschrijft hoe modelontwerp en hardware elkaar beïnvloeden. Het team gebruikte onder meer FP8: een compacte manier om getallen op te slaan en ermee te rekenen. Dat kan geheugen en gegevensverkeer besparen, maar minder precisie kan ook de stabiliteit van training raken. Daarom vraagt het optellen van tussenresultaten om voldoende nauwkeurigheid. De onderzoekers beschrijven bovendien extra gegevensverplaatsingen wanneer de hardware bepaalde schaalbewerkingen niet rechtstreeks ondersteunt. Nxt-duiding: twee chips met een vergelijkbaar aantal berekeningen per seconde hoeven hetzelfde model dus niet even goed te trainen. Welke bewerkingen zij ondersteunen, hoe nauwkeurig die zijn en hoeveel heen-en-weerwerk nodig is, bepaalt mede wat een snelheidsgetal in de praktijk betekent.
De software heeft een hardwareadres
Ook de openbare code laat zien waarom overstappen werk is. DeepSeeks DeepGEMM bevat kleine, sterk geoptimaliseerde rekenonderdelen, waaronder matrixvermenigvuldigingen en berekeningen voor expertmodellen. De actuele documentatie noemt expliciet NVIDIA-hardware van de architecturen SM90 of SM100 en het bijbehorende CUDA-gereedschap als vereisten. Zulke rekenonderdelen heten kernels. Ze voeren terugkerende bewerkingen uit die belangrijk zijn voor de snelheid van het geheel. Dat deze code openbaar beschikbaar is, maakt haar nog niet geschikt voor iedere processor. Nxt-duiding: een andere hardwarefamilie vraagt passende implementaties en controle van hun uitkomsten. Deze repository bewijst overigens niet dat alle huidige DeepSeek-training uitsluitend op NVIDIA draait; zij toont de afhankelijkheden van één openbaar softwareonderdeel.
Huawei bouwt aan de verbinding ertussen
Huawei presenteerde op 17 september Peerium, een aanpak om grote aantallen processors als één samenhangend systeem te laten werken. Daarbij hoort UnifiedBus, een verbinding die volgens het bedrijf onder meer rekenchips, geheugen, opslag en netwerkonderdelen via één protocol kan koppelen. Dat protocol is de afspraak waarmee onderdelen gegevens uitwisselen. Huawei noemt gedeelde geheugenadressering en verbindingen tussen gelijkwaardige onderdelen als bouwstenen. Het bedrijf meldde ook dat een Atlas 950-cluster met 256.000 kaarten wordt uitgerold. Dat is een claim van Huawei; de aankondiging identificeert deze installatie niet als DeepSeeks trainingscluster. Nxt-duiding: het relevante idee is breder dan één snellere chip. De onderdelen moeten hun tussenresultaten op tijd bij elkaar kunnen krijgen.
Een chipplanning is nog geen trainingsresultaat
In een afzonderlijke presentatie van dezelfde dag plant Huawei de Ascend 960DT voor het eerste kwartaal van 2027. Dat is een toekomstige beschikbaarheidsclaim, geen reeds geleverde capaciteit. Ook benadrukt het bedrijf CANN, zijn softwarebasis voor Ascend. Volgens Huawei zijn daarmee inmiddels meer dan veertig modellen oorspronkelijk getraind. Die claim spreekt het idee tegen dat training op zulke hardware per definitie onmogelijk is. Zij beantwoordt echter niet welke prestaties een specifiek groot DeepSeek-model zal halen, tegen welke kosten of met welke betrouwbaarheid. Nxt-duiding: vraag bij een volgende aankondiging daarom naar het model, de werkelijk gebruikte hardware en de meetmethode. Een algemene lijst ondersteunde software of een roadmap vervangt zo’n concreet resultaat niet.
Voor ontwikkelaars telt het hele leerproces
Ook wie in Nederland of België een kleiner AI-project maakt, komt hetzelfde onderscheid tegen bij opslaan en hervatten. PyTorch beschrijft dat een momentopname voor verdere training meer bevat dan alleen de modelparameters. Ook de toestand van de optimizer, de software die deze parameters bijwerkt, moet worden bewaard. Daarnaast kunnen de bereikte trainingsronde en de laatst gemeten fout worden opgeslagen. Alleen een modelbestand verplaatsen is dus niet hetzelfde als het hele leerproces voortzetten. Nxt-duiding: bij het beoordelen van een ander platform helpen drie afzonderlijke vragen. Kan het model er antwoorden geven? Kan de training er draaien en worden hervat? En blijft dat op de gewenste schaal bruikbaar? De merknaam op de chip beantwoordt die vragen niet.
Verder bij de bron
Lees zelf de onderzoeken, uitleg en aankondigingen achter dit verhaal.
- [1] The Information — openbare berichtpreview, 21 september 2026
- [2] PyTorch — hoe modeltraining werkt
- [3] DeepSeek — technisch rapport V3, december 2024, bijgewerkt februari 2025
- [4] DeepSeek — hardware en modelontwerp, mei 2025, bijgewerkt december 2025
- [5] DeepSeek — DeepGEMM, actuele projectdocumentatie
- [6] Huawei — Peerium en UnifiedBus, 17 september 2026
- [7] Huawei — chipplanning en CANN, 17 september 2026
- [8] PyTorch — modellen en trainingsmomentopnamen bewaren