Je laat een AI-assistent een lange uitlegvideo samenvatten. Heeft hij dan werkelijk alles bekeken? Dat hangt af van de manier waarop hij zoekt. Qwen beschreef op 18 september bij Qwen3.8-Omni-Flash hoe een assistent vanuit je vraag steeds gerichter beeld en geluid opzoekt. Zo hoeft hij niet ieder beeld te verwerken. Dat is nuttig als je één stap uit een les wilt terugvinden, maar een selectie is geen bewijs dat niets ontbreekt. De leverancier vermeldt ook Nederlandse spraakherkenning. Daarmee is nog niet aangetoond hoe goed een drukke Nederlandse of Vlaamse lesopname wordt begrepen.
Waarom kan een kort moment verdwijnen?
Bij een vaste steekproef krijgt het model slechts beelden met een bepaalde tussenruimte. Google beschrijft voor de gewone videoverwerking in de Gemini API standaard één beeld per seconde. Een API is de aansluiting waarmee een app een model gebruikt. Google waarschuwt dat snelle bewegingen en korte beeldwisselingen daardoor details kunnen verliezen. Stel dat een docent heel kort een verkeerde uitkomst aanwijst. Die aanwijzing kan tussen twee geselecteerde beelden vallen. Dezelfde documentatie beschrijft voor onder meer Gemini 3.8 Flash een zoekende stand: het model verkent de tijdlijn en past de beeldfrequentie en resolutie aan de vraag aan.
Inzoomen helpt bij een andere beperking
Ook de grootte van een geselecteerd beeld telt mee. De Core-hulpmiddelen van Qwen halen videobeelden op met een automatisch gekozen resolutie en beeldfrequentie. Resolutie gaat over de hoeveelheid beeldpunten; beeldfrequentie over hoeveel beelden per seconde worden gekozen. Dat zijn verschillende instellingen. De gereedschappen kunnen daarnaast een los videobeeld bewaren en een deel van een afbeelding uitsnijden. Bij een rekenvoorbeeld op een schoolbord kun je zo gericht naar het stukje met de berekening kijken. Onze gevolgtrekking: vraag bij onduidelijke kleine tekst om dat fragment of die uitsnede. Alleen een vloeiende samenvatting geeft je geen zicht op het gebruikte beeld.
Eerst zoeken in een inhoudsopgave
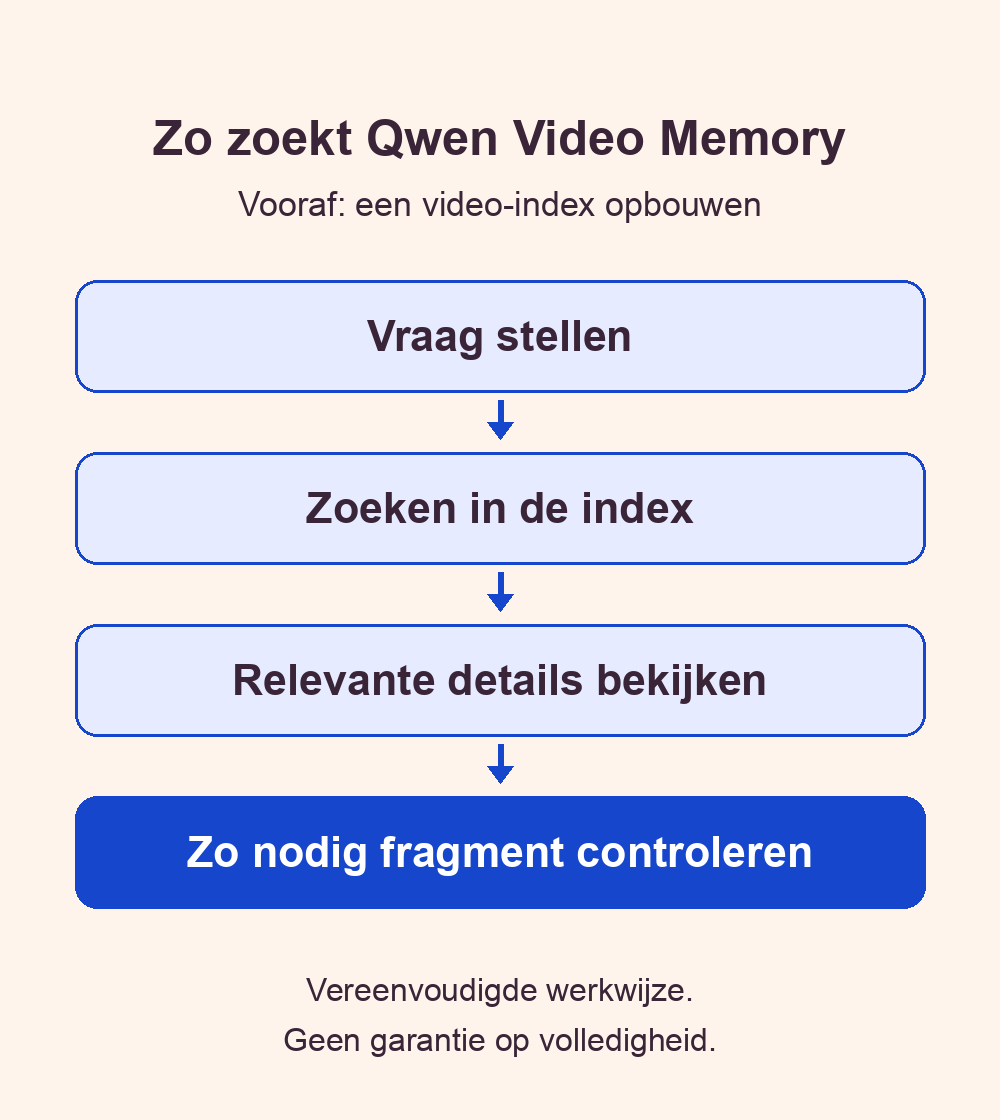
Qwens afzonderlijke Video Memory maakt een doorzoekbare beschrijving van een lange video. Die is geordend van een algemeen overzicht naar kleinere gebeurtenissen, met onder meer schermtekst en uitgeschreven spraak. Bij een vraag zoekt de assistent eerst een passend onderdeel, bekijkt de details en kan hij daarna het oorspronkelijke fragment controleren. Vergelijk het met een inhoudsopgave die je naar de juiste bladzijde helpt. De beschrijving helpt zoeken; het oorspronkelijke beeld blijft nodig wanneer een detail daarin onvoldoende duidelijk is.
Beeld en geluid zijn niet hetzelfde
De aparte uitbreiding Omni Memory verwerkt bij het opbouwen van zijn video-overzicht stukken van dertig seconden, met beeld én bijbehorend geluid. Volgens de handleiding koppelt het model uitspraken aan personen en legt het ook toon en omgevingsgeluid vast. Dat is een ontworpen werkwijze, geen garantie dat iedere spreker correct wordt herkend. Het verschil is praktisch: een docent kan iets aanwijzen terwijl iemand buiten beeld een vraag stelt. Losse plaatjes vertellen niet wie wat zei. De handleiding zegt expliciet dat Qwens gereedschap voor losse videobeelden het geluid weglaat. Omni Memory kan gevonden fragmenten juist opnieuw mét geluid laten onderzoeken.
Een nette pdf kan toch iets missen
De Video2Note-uitbreiding laat zien waarom je ook de uitkomst moet controleren. Ze maakt lesnotities door eerst de video te analyseren, daarna tekst met tijdstippen te laten opstellen en daarbij beelden te verzamelen. De huidige instructies beschrijven geen afzonderlijke eindcontrole van de pdf door een model. Ook kan een eenvoudiger document verschijnen wanneer een deel van de verwerking mislukt; waarschuwingen moeten dan ontbrekende stukken melden. Voor je huiswerk betekent dat: bekijk zulke meldingen en leg een belangrijke uitleg naast het genoemde fragment. Mooie opmaak en een passende afbeelding bewijzen niet dat alle stappen uit de les zijn meegenomen.
Welke onderdelen gebruikt jouw assistent?
Qwen-MM-Plugins is een verzameling losse uitbreidingen voor AI-werkomgevingen, geen kant-en-klare schoolapp. De openbare projectbeschrijving maakt onderscheid tussen lokaal beelden uitlezen en een modeldienst aanroepen voor inhoudelijke verwerking. Voor de video-overzichten en lesnotities noemt ze aanvullende software en toegang tot zo’n dienst als vereisten. Welke onderdelen zijn geïnstalleerd, bepaalt dus mede wat een assistent met je bestand kan doen. Voor leerlingen en makers in Nederland en België is deze uitleg daarom geen aankondiging dat alle functies in hun eigen chatapp beschikbaar zijn. Controleer welke videofunctie die app werkelijk aanbiedt. Vraag vervolgens om concrete tijdstippen en bekijk beslissende passages zelf.
Verder bij de bron
Lees zelf de onderzoeken, uitleg en aankondigingen achter dit verhaal.
- [1] Qwen — Video Memory: zoeken en terugkijken
- [2] Google — video begrijpen met Gemini
- [3] Qwen — Core: beelden uit een video halen
- [4] Qwen — Omni Memory: beeld en geluid samen
- [5] Qwen — gereedschappen en afhankelijkheden
- [6] Qwen — oorspronkelijke uitleg, 18 september 2026
- [7] Qwen — Video2Note: grenzen van automatisch gemaakte lesnotities